RAG entreprise : guide complet pour 2026
15 août 2026 · mis à jour le 15 août 2026 · 19 min de lecture
Rédigé avec l'assistance de l'IA. Publié automatiquement selon nos règles éditoriales.
En 2025, le marché mondial du RAG est estimé à 1,94 milliard de dollars, avec une projection à 9,86 milliards de dollars en 2030 et un TCAC de 38,4 % selon une étude sectorielle citée par France Num. Ce n'est pas un signal de laboratoire, c'est un basculement d'architecture, parce que le RAG répond enfin au vrai problème de l'IA en entreprise, retrouver les bonnes sources internes, au bon moment, avec assez de traçabilité pour être exploitable en production. Pour une rag entreprise, la question n'est plus « faut-il tester ? », mais « comment tenir dans la durée, sans dériver sur la qualité, les accès et la gouvernance ».
Le sujet a pris autant d'ampleur parce que les grands modèles de langage restent limités par leur mémoire figée et leur tendance à produire des réponses non vérifiables. Des synthèses sectorielles indiquent qu'avec une architecture RAG, la précision des réponses peut progresser de 10 à 20 % par rapport à une base sans récupération, et que certaines évaluations contrôlées observent jusqu'à 50 % de réduction des hallucinations, ce qui explique son adoption rapide en environnement critique. Dans les organisations françaises, cela compte encore plus, car France Num positionne le RAG comme une méthode de recherche intelligente et d’analyse documentaire adaptée aux contenus internes, avec un accent sur la fiabilité, l'actualisation et la conformité.
Le bon point de départ n'est pas la démo, c'est le cas d'usage. Recherche documentaire interne, support aux équipes conformité, base de connaissances métier, assistance aux opérations, ces scénarios ont un point commun, ils dépendent de documents vivants, d'autorisations fines et de réponses sourcées. Un système bien conçu réduit la chasse aux fichiers, limite les réponses inventées et rend les échanges audités, mais seulement si la donnée source est gérée comme un actif de production, pas comme un simple répertoire.
Pour cadrer l'enjeu côté marque et communication, la logique est la même que dans une stratégie d’image de marque avec un photographe, la confiance se construit sur des preuves concrètes, pas sur un discours générique. Le RAG fonctionne quand l'entreprise accepte cette discipline de preuve à chaque réponse.
Table des matières
- Pourquoi le RAG est devenu incontournable en entreprise
- Concevoir un pipeline de préparation des données solide
- Optimiser la récupération avec une approche hybride
- Sécuriser l'accès aux données et garantir la conformité
- Mesurer et améliorer la qualité des réponses
- Exploiter et maintenir un RAG vivant dans le temps
Pourquoi le RAG est devenu incontournable en entreprise
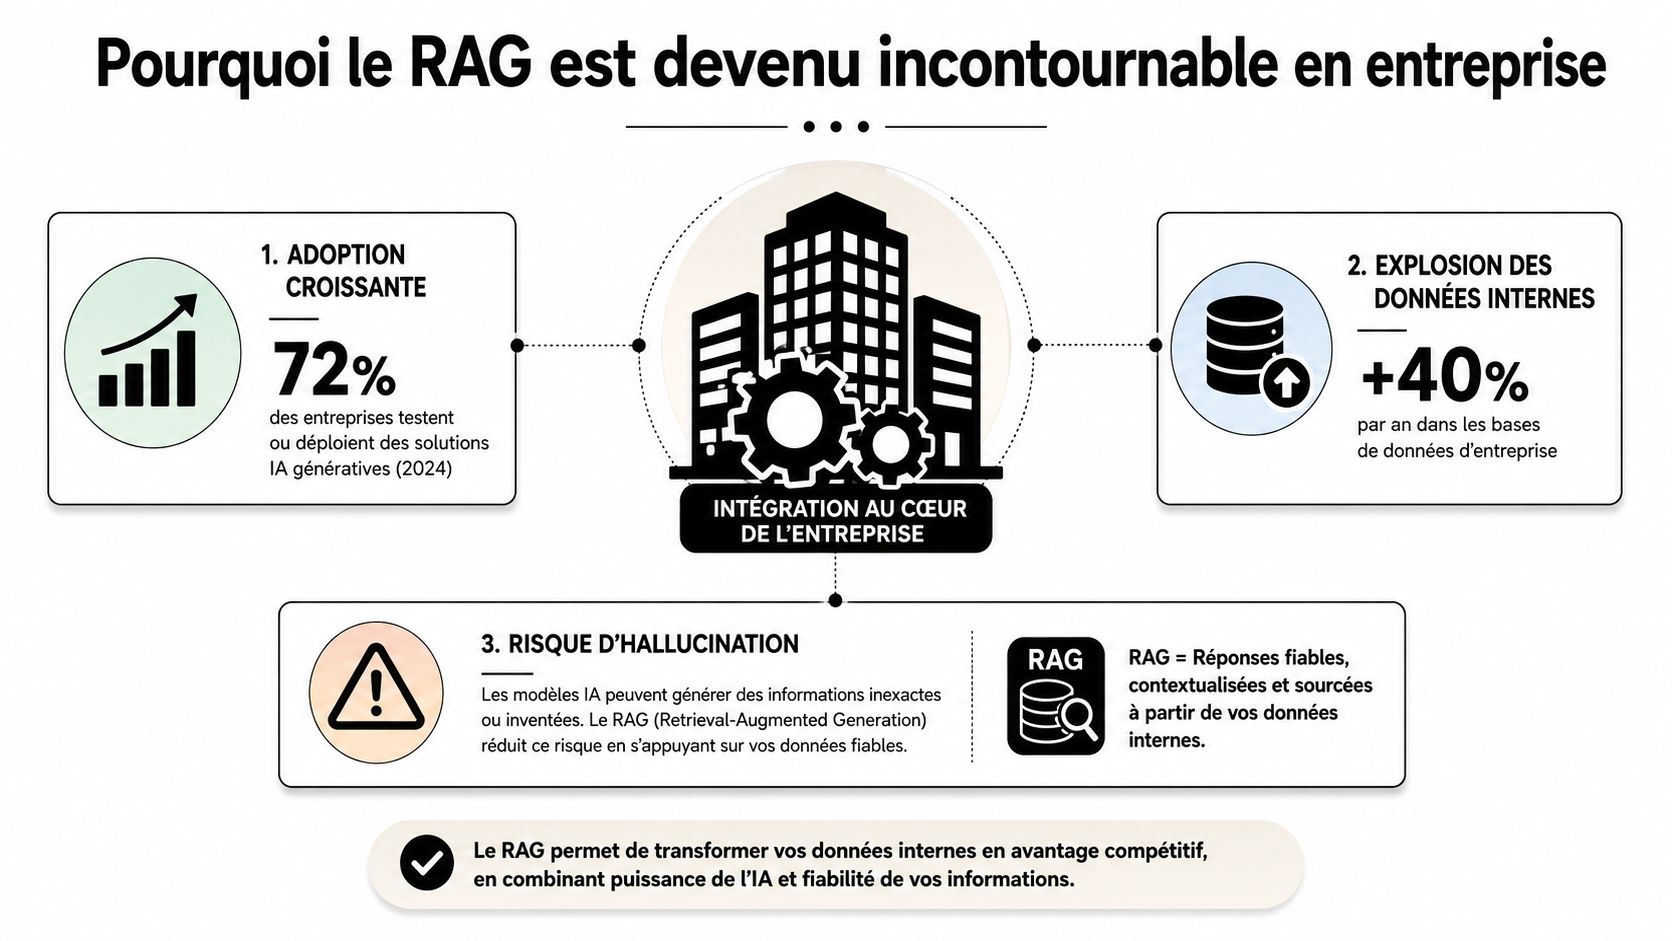
Le RAG s'impose parce qu'il traite un défaut récurrent des LLM, ils produisent vite, mais leur réponse reste fragile dès qu'il faut s'appuyer sur un corpus interne précis. En entreprise, cette fragilité devient immédiatement un sujet de production quand il faut répondre à partir de contrats, de procédures, de politiques internes ou de bases réglementaires. France Num présente justement le RAG comme une approche de recherche intelligente et d'analyse documentaire adaptée aux organisations qui veulent interroger leurs contenus de façon plus fiable et plus actualisée, ce qui correspond aux attentes des directions métier et conformité. France Num
La dynamique dépasse le cadre technique. Une projection de marché à 9,86 milliards de dollars en 2030 avec un TCAC de 38,4 % montre que le RAG quitte les POC pour devenir une brique d'industrialisation de l'IA documentaire. Sur le terrain, l'arbitrage est clair, les entreprises ne cherchent plus un assistant « créatif », elles veulent un système qui va chercher la bonne version du bon document et qui limite l'exposition de données non autorisées. Étude sectorielle 2025 sur le marché mondial du RAG
Ce que le RAG change vraiment
Le changement majeur, c'est la connexion entre IA générative, données internes et traçabilité. Une architecture RAG relie la récupération documentaire à la génération, ce qui réduit la dépendance à la mémoire du modèle et donne un meilleur contrôle sur les sources réellement utilisées. Dans les entreprises où les contenus évoluent souvent, cette séparation entre stockage gouverné et génération contextuelle évite de relancer un entraînement complet à chaque mise à jour utile.
Règle pratique. Si votre réponse doit rester valable demain avec le même niveau de fiabilité qu'aujourd'hui, le RAG est souvent plus adapté qu'un modèle purement conversationnel.
Il faut aussi garder une lecture réaliste des limites. Le RAG ne supprime pas tous les écarts de raisonnement, il ancre surtout la réponse dans un corpus défini et réduit le risque de dérive. C'est pour cela qu'il est devenu un standard d'architecture dans les environnements où il faut démontrer d'où vient la réponse, qui a accès à quoi, et comment la décision a été produite.
Les cas d'usage qui reviennent le plus
- Recherche documentaire interne, pour retrouver des procédures, guides ou politiques sans fouiller plusieurs outils.
- Support conformité et juridique, quand il faut citer la bonne clause ou la bonne version d'un texte.
- Assistant métier, pour aider les équipes à exploiter une connaissance dispersée dans SharePoint, Confluence, tickets ou PDF.
- Soutien à la production, quand les opérateurs doivent vérifier une consigne ou un mode opératoire en contexte.
Ce qui relie ces scénarios, c'est la fiabilité attendue par les métiers. Un RAG entreprise utile ne remplace pas les experts, il leur fait gagner du temps, réduit les erreurs de recherche, et s'intègre dans un cadre où la qualité documentaire, la gouvernance des accès et le maintien en condition opérationnelle comptent autant que la réponse elle-même. Pour la même logique de preuve appliquée à la confiance, la relation entre contenu et crédibilité fonctionne comme dans une stratégie d’image de marque avec un photographe.
Concevoir un pipeline de préparation des données solide
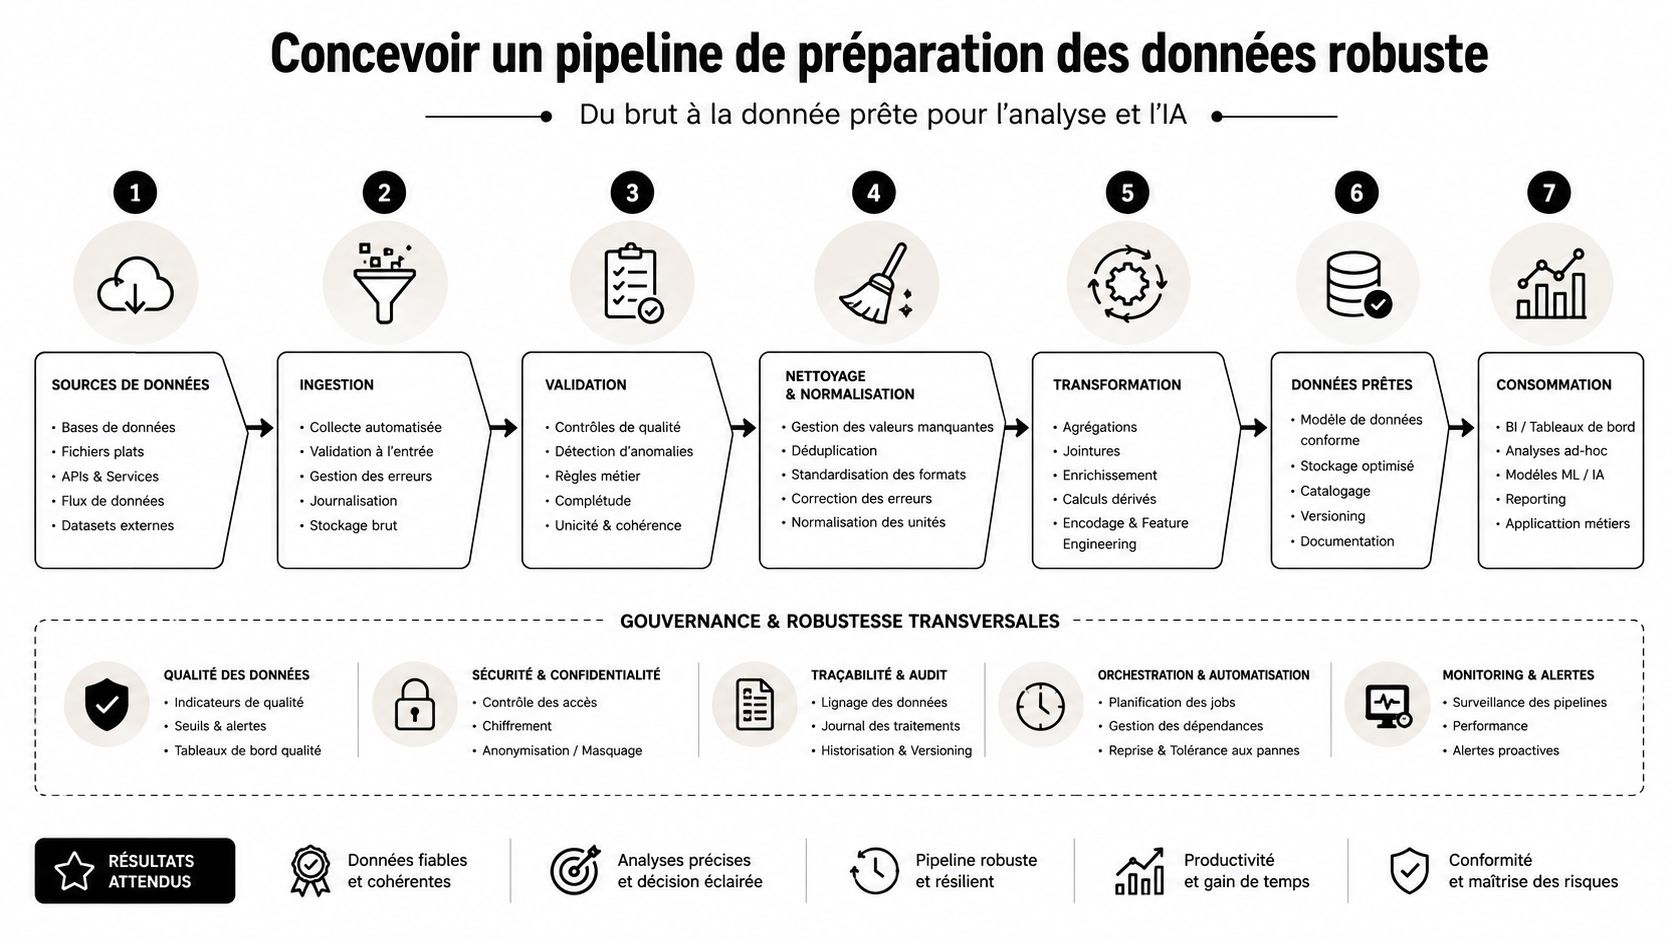
La qualité d'un système RAG se joue avant l'indexation, pas après. Dans la plupart des échecs que j'ai vus en production, le problème ne venait pas du modèle génératif, mais du corpus, documents incohérents, versions obsolètes, métadonnées absentes, ou PDF mal extraits. Le guide gouvernemental français sur le RAG décrit bien l'enchaînement préparation des données, récupération, puis génération, tout en précisant que les étapes de conversion, nettoyage, segmentation, enrichissement, vectorisation et indexation ne sont pas toutes obligatoires selon le cas d'usage et le modèle visé. Guide RAG de la DINUM et FranceNum
Le minimum vital à mettre en place
Le pipeline commence par parsing, puis nettoyage, segmentation, enrichissement et vectorisation. En pratique, j'insiste toujours sur quatre points. D'abord, extraire le texte proprement depuis les formats sources. Ensuite, découper selon la structure logique du document, pas selon une taille arbitraire. Puis ajouter des métadonnées exploitables, enfin garder un lien clair entre chaque chunk et son origine.
Le guide technique destiné à l'entreprise recommande une segmentation souvent comprise entre 300 et 1 000 tokens, avec un recouvrement de 10 à 20 % ou 50 à 100 tokens selon la granularité recherchée, et un découpage prioritaire par titres, puis paragraphes, puis phrases. Guide pratique RAG en entreprise Ces paramètres ne sont pas magiques, mais ils évitent deux erreurs classiques, des chunks trop longs qui diluent le signal, ou trop courts qui cassent le contexte.
Ce qui dégrade la récupération
Le vrai piège, c'est de traiter le corpus comme un simple dépôt de documents. Sans normalisation ni gestion des versions, la récupération devient instable, même si l'index est récent. Une base pleine de doublons, de documents obsolètes ou de champs mal renseignés produit des réponses qui ont l'air convaincantes mais s'appuient sur des fragments incomplets.
Un corpus RAG doit être gouverné comme une base de connaissance, pas comme un dossier partagé.
Pour tenir dans le temps, il faut aussi instrumenter les transformations. Je recommande de tracer le document source, la date d'ingestion, la version détectée, les métadonnées appliquées et les éventuelles règles de filtrage. Ce suivi paraît lourd au début, mais il devient indispensable dès qu'un métier demande pourquoi une réponse a cité une version plutôt qu'une autre. En exploitation, c'est souvent là que se joue la différence entre un prototype qui marche une semaine et un système que les équipes peuvent encore auditer six mois plus tard.
Où les métadonnées font la différence
Les métadonnées ne servent pas seulement au confort, elles pilotent la qualité de récupération. Elles permettent de filtrer par produit, région, niveau de confidentialité, date de validité ou type de document. Sans elles, le moteur récupère plus large, mais pas mieux. Dans un environnement métier riche en terminologie, cette finesse fait souvent la différence entre une réponse exploitable et une réponse juste « plausible ».
La gouvernance documentaire compte autant que la technique. Si les sources ne sont pas classées, si les propriétaires de contenu ne valident pas les mises à jour, ou si les règles d'accès changent sans être répercutées dans le pipeline, le RAG finit par citer le mauvais document avec assurance. Le bon réflexe consiste à traiter chaque lot d'ingestion comme une petite chaîne de production, avec contrôle de qualité, gestion des rejets et suivi des écarts.
Optimiser la récupération avec une approche hybride
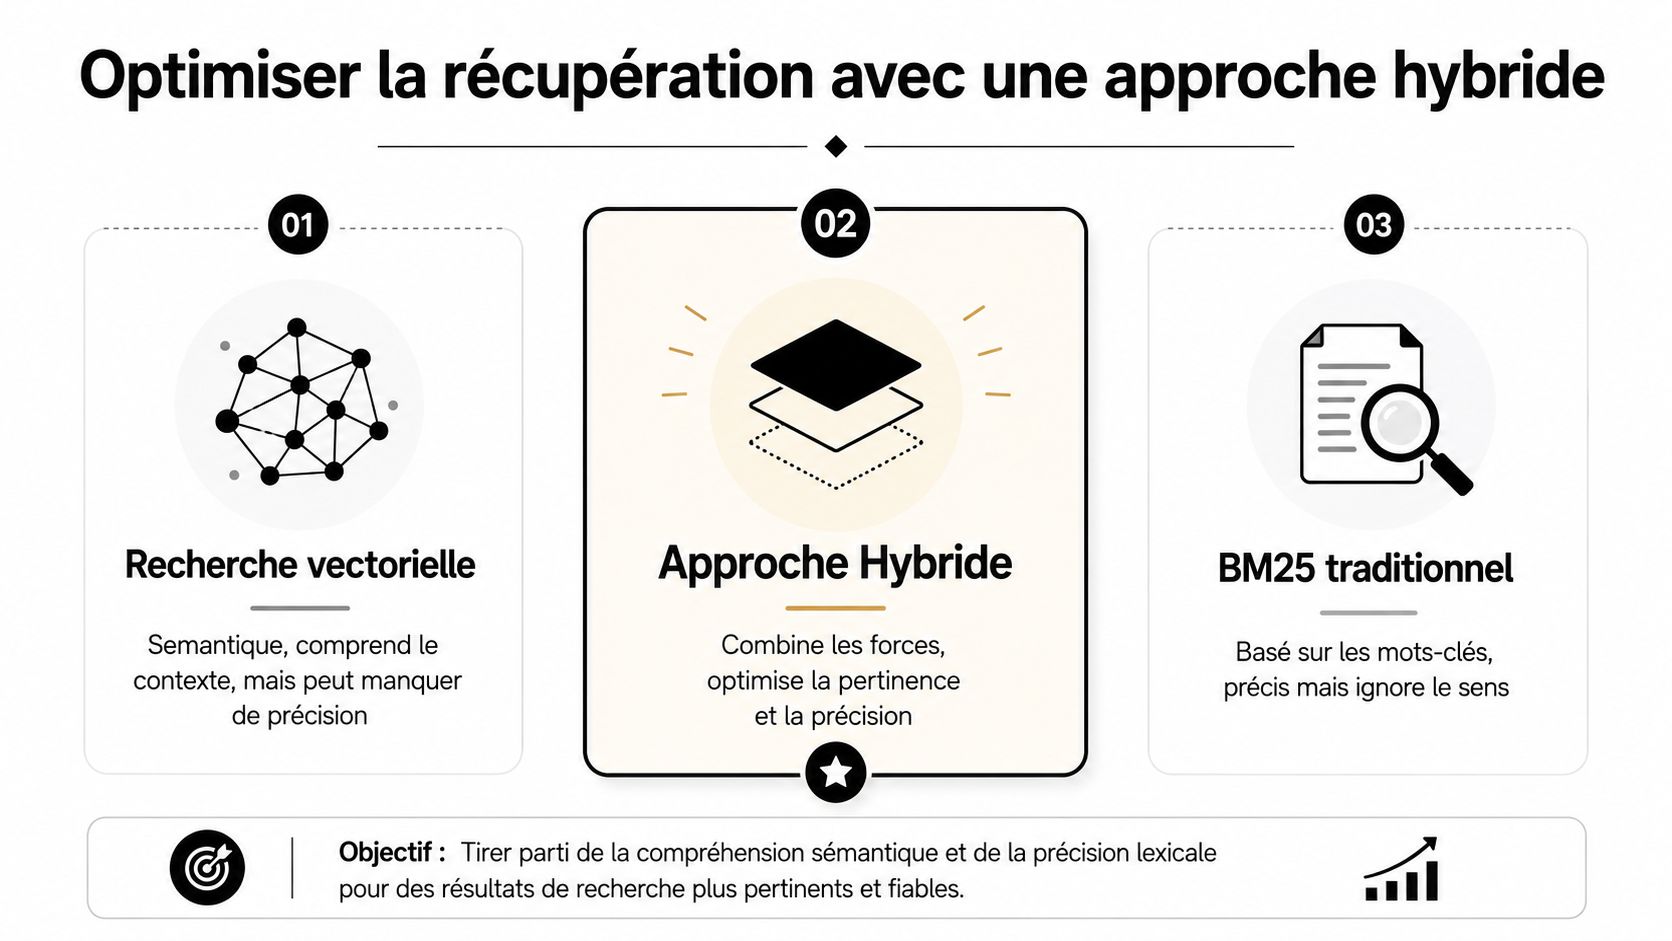
Sur des corpus métiers, une recherche vectorielle seule comprend souvent l'intention, mais elle perd en précision dès que les requêtes contiennent du jargon, des sigles ou des références internes. BM25 fait l'inverse, il retrouve bien les termes exacts, mais il laisse de côté une partie du sens. Les architectures qui tiennent en production combinent donc les deux approches, puis ajoutent un reranking pour remettre en tête les passages réellement utiles. Le gain ne vient pas du mot « hybride », il vient d'un contexte mieux cadré, avec moins de bruit envoyé au modèle.
Pourquoi le tout vectoriel plafonne vite
Dans un environnement métier, les requêtes portent souvent des acronymes, des noms de produits, des références internes ou des formulations très normées. Un système purement dense peut passer à côté de cet ancrage lexical. Un moteur purement lexical, lui, renvoie des textes qui contiennent les bons mots, mais pas forcément le bon sens. L'approche hybride garde la couverture du lexical et la souplesse du sémantique, ce qui limite les écarts les plus pénibles à corriger après déploiement.
Le reranking par cross-encoder affine ensuite le tri des candidats. C'est une étape que beaucoup de POC traitent trop tard, alors qu'en production elle change souvent la perception de fiabilité. Les retours d'expérience sur le RAG d'entreprise insistent aussi sur le fait que la qualité se mesure avec des critères comme faithfulness, answer relevance et context precision. Guide technique RAG en entreprise
Ce que je filtre avant la génération
Le filtrage par métadonnées n'est pas un confort, c'est un moyen de rendre la récupération cohérente avec le contexte utilisateur et l'usage visé. Sur un même fonds documentaire, je peux vouloir limiter la recherche à une gamme de produits, à une filiale, à une langue ou à une période de validité. Cette couche évite d'envoyer au modèle des passages proches sur le plan sémantique, mais hors périmètre opérationnel.
Bon réflexe. Réduisez d'abord le corpus candidat, puis laissez le modèle générer. Ne demandez pas à la génération de compenser une récupération mal cadrée.
En production, je traite la récupération comme une chaîne de décisions, d'abord l'accès, ensuite le filtrage métier, puis le classement, enfin le contexte final. Ce séquencement paraît austère, mais il réduit les erreurs difficiles à diagnostiquer quand les équipes doivent comprendre pourquoi une réponse est sortie plutôt qu'une autre. Sans cette discipline, on obtient un système rapide, mais qui mélange facilement des passages valides et des documents hors sujet.
Ce qui marche réellement
- Recherche hybride, pour combiner précision lexicale et couverture sémantique.
- Reranking, pour resserrer la liste des passages avant génération.
- Filtres de métadonnées, pour éviter les sources hors périmètre.
- Jeu d'évaluation dédié, pour vérifier que parsing, chunks et filtres tiennent dans la durée.
Le point faible n'est donc pas seulement le modèle, c'est la qualité de la récupération. Dans une RAG entreprise, c'est souvent là que se joue la perception de fiabilité.
Sécuriser l'accès aux données et garantir la conformité
Le faux débat consiste à demander si le RAG est « sûr » en soi. La vraie question est plus concrète, quels documents peut-on exposer, à quels utilisateurs, avec quelles traces, et dans quelles limites de conformité. Les guides publics français insistent sur la traçabilité des sources, l'accès aux bases documentaires et la conformité comme critères clés de pertinence du RAG, ce qui rappelle que la sécurité n'est pas une couche après coup, c'est une condition de fonctionnement. Guide de la génération augmentée par récupération
Le vrai sujet, c'est le cloisonnement
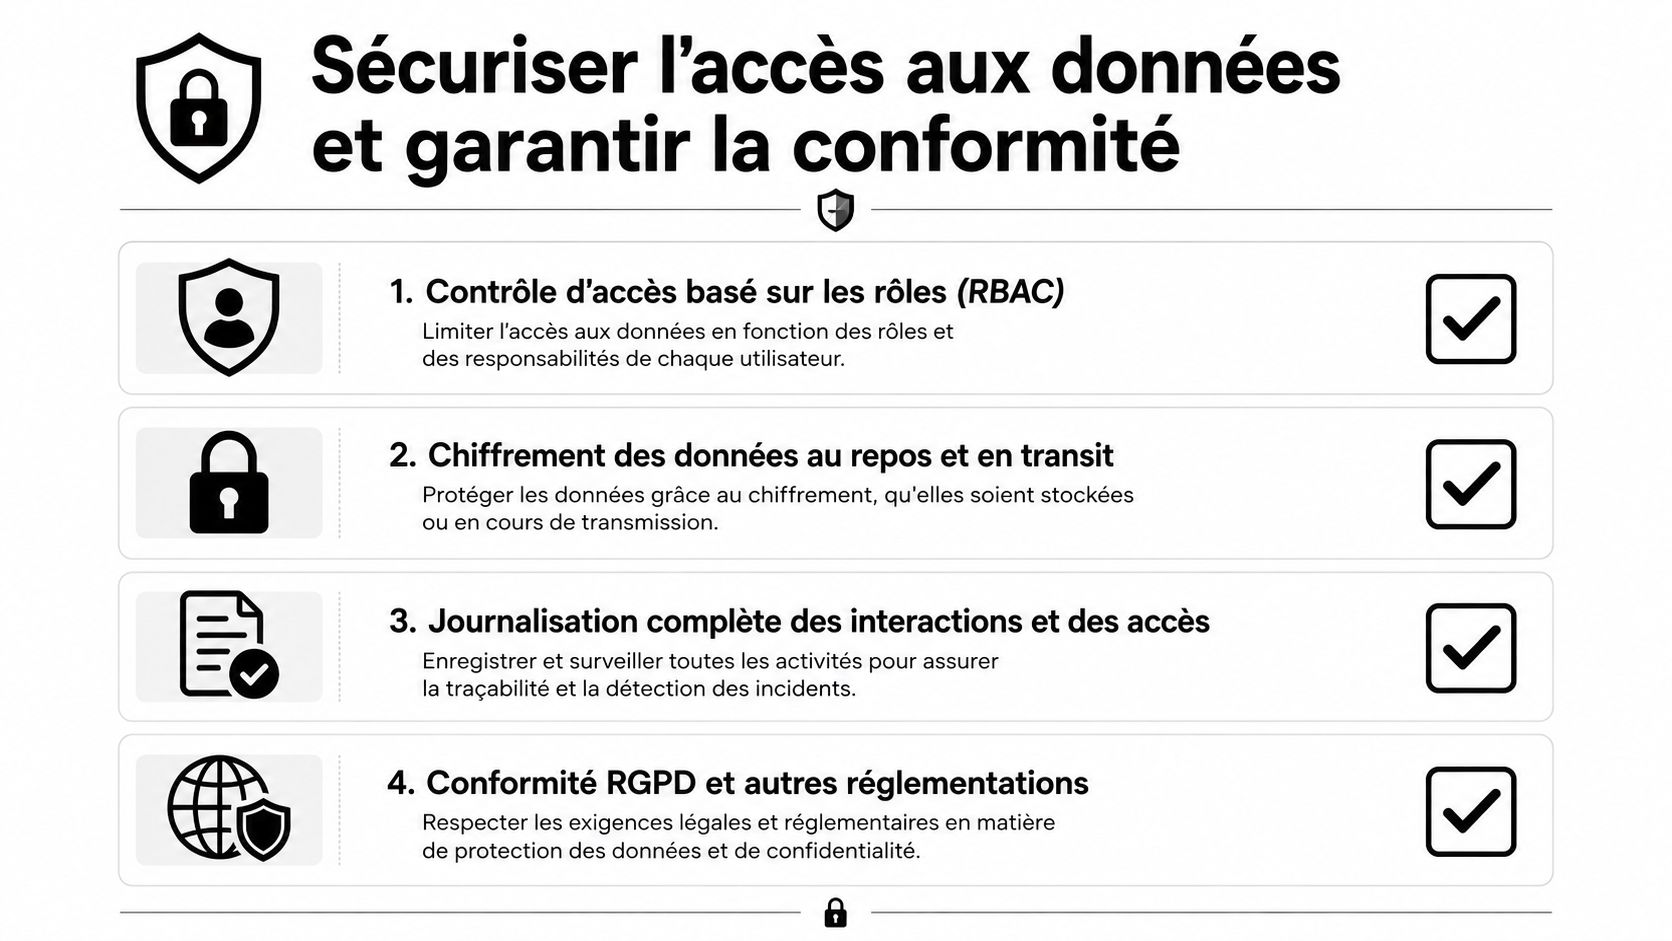
Dans les environnements à données sensibles, je pars toujours d'un modèle d'autorisation granulaire. Les contenus ne doivent pas être exposés parce qu'ils existent dans l'index, ils doivent l'être parce que l'utilisateur a le droit d'y accéder. Les recommandations techniques pour le RAG d'entreprise convergent sur cette idée, avec des contrôles d'accès, de la journalisation, du chiffrement et des mécanismes de conformité pensés dès l'architecture. Secure RAG, architecture patterns for safe enterprise AI
Le point aveugle le plus fréquent, c'est l'auditabilité. Un journal d'audit utile ne se contente pas de dire qu'une requête a été lancée. Il doit permettre de savoir quel utilisateur a interrogé quel périmètre, quels documents ont été consultés, quelles règles ont filtré la réponse, et quelle version du corpus a servi. Sans cette chaîne, impossible d'expliquer une réponse problématique ou de prouver qu'un document confidentiel n'a pas débordé.
Ce qu'il faut vérifier avant la mise en production
- Accès basé sur les rôles, pour aligner les réponses avec le périmètre réel de l'utilisateur.
- Chiffrement des données, au repos et en transit, pour réduire l'exposition en cas d'incident.
- Journalisation des accès, pour reconstruire le cheminement d'une réponse.
- Conformité RGPD, avec repérage des données personnelles et sensibles avant déploiement.
Le cadre français pousse clairement à identifier les données personnelles, sensibles et les contraintes RGPD avant de lancer la solution. Ce n'est pas un détail juridique, c'est une contrainte d'architecture. Si vous ignorez cette étape, vous finissez avec un moteur techniquement performant mais inacceptable pour les équipes de sécurité.
L'erreur qui coûte le plus cher
Le réflexe le plus dangereux consiste à sur-exposer pour aller plus vite. On ouvre trop large, on logge trop peu, puis on découvre que le système a remonté un document hors périmètre à une population trop large. Mieux vaut un démarrage plus lent, avec des règles strictes et des audits clairs, qu'une mise en service rapide suivie d'une restriction en urgence.
Dans la plupart des déploiements réussis, la sécurité n'a pas freiné le projet, elle l'a rendu publiable. C'est la différence entre un prototype interne et une rag entreprise qu'on peut réellement confier aux métiers.
Mesurer et améliorer la qualité des réponses
Un système RAG qui n'est pas mesuré dérive vite. Le bon réflexe consiste à suivre la qualité sur deux plans, la récupération et la réponse finale, parce qu'un texte bien rédigé peut rester mal relié aux bonnes sources. En production, je regarde d'abord si le modèle s'appuie sur le bon contexte, puis si la réponse couvre vraiment la demande de l'utilisateur. Sans ce double contrôle, on confond aisément une sortie fluide avec une réponse fiable.
Table de suivi
| Métrique | Définition | Objectif |
|---|---|---|
| Faithfulness | Vérifie si la réponse reste fidèle aux sources récupérées | Réduire les écarts entre le texte généré et les documents |
| Answer relevance | Mesure si la réponse traite réellement la question posée | Améliorer l'utilité perçue par l'utilisateur |
| Context precision | Évalue la qualité du contexte récupéré avant génération | Mieux sélectionner les passages transmis au modèle |
| Groundedness | Apprécie l'ancrage factuel de la réponse dans le corpus | Limiter les assertions non soutenues |
Ces indicateurs ne servent pas à faire de beaux tableaux de bord. Ils servent à repérer où le système décroche, retrieval, génération, ou les deux à la fois. Quand la faithfulness baisse alors que l’answer relevance reste correcte, le modèle répond souvent juste à côté du corpus. Quand la context precision chute, le problème vient plus souvent de la sélection des passages que du texte produit.
Le jeu d'évaluation doit venir du terrain
Le meilleur jeu de tests n'est pas un corpus synthétique, c'est une collection de questions réelles. Les demandes des utilisateurs révèlent les ambiguïtés métier, les formulations courtes, les acronymes et les variantes de vocabulaire qui font échouer les évaluations trop propres. Je pars toujours d'une base de validation issue des usages, puis j'y ajoute des cas limites, des documents obsolètes et des questions volontairement piégeuses.
Ce jeu doit aussi refléter les contraintes de production. Il faut y inclure des questions posées par des profils différents, des documents partiellement redondants, des références de version ambiguës et des corpus dont la qualité varie selon les équipes. C'est là qu'on voit si le système reste stable quand le contexte est imparfait, ce qui est le cas le plus fréquent en entreprise.
Pratique saine. Si vos tests ne ressemblent pas aux tickets ou aux requêtes réelles, vos métriques seront flatteuses mais peu fiables.
Ce qu'il faut automatiser
Les tests de régression doivent couvrir les changements de parsing, de découpage en chunks, de filtres et de classement. Dès qu'un changement touche l'index, le reranker ou les métadonnées, il faut rejouer un jeu de questions représentatif pour repérer les dérives. Le but n'est pas seulement de détecter les échecs visibles, c'est aussi de repérer les réponses bien écrites mais faiblement fondées.
La supervision humaine reste indispensable sur les cas sensibles. En pratique, je réserve la revue humaine aux réponses à fort impact, puis je transforme les retours en corrections sur la récupération, les sources et les règles d'accès. C'est ce cycle de contrôle qui évite qu'un RAG entreprise se contente de paraître bon alors que sa qualité réelle baisse en silence.
Exploiter et maintenir un RAG vivant dans le temps
Un RAG qui tient en production ne se juge pas à son lancement, mais à sa capacité à rester fiable quand les documents bougent. Dès que les contenus changent, que des doublons apparaissent, que des versions obsolètes restent accessibles ou que le rythme de re-indexation n'est plus maîtrisé, la qualité des réponses se dégrade. Les contenus français sur le sujet rappellent bien que la valeur du RAG dépend d'une documentation qui évolue, d'une intégration aux outils métier et d'une gouvernance continue. Analyse sur le RAG comme système de connaissance à opérer
Ce qu'il faut opérer au quotidien
J'ai vu des systèmes techniquement corrects devenir inutilisables parce que personne n'avait défini la responsabilité de mise à jour. Qui corrige un document source, qui retire les doublons, qui valide la version de référence, qui décide qu'un corpus doit être re-indexé, ce sont des questions opérationnelles, pas des détails. Si elles restent sans réponse, la qualité se dégrade lentement et les utilisateurs cessent de faire confiance au système.
Le bon modèle d'exploitation repose sur une séparation claire des rôles. Les équipes métier valident le contenu et les versions utiles. Les équipes techniques surveillent l'index, les performances de récupération et les régressions. La sécurité contrôle les accès, les traces et les règles de partage. Cette organisation peut sembler lourde au départ, mais elle évite le piège du « tout le monde pense que quelqu'un d'autre s'en occupe ».
Les signaux d'alerte à surveiller
- Hausse des réponses hésitantes, signe que le corpus manque de stabilité ou de couverture.
- Retour fréquent de documents obsolètes, souvent lié à une mauvaise gestion des versions.
- Chute de pertinence sur des requêtes métier, qui pointe un problème de chunking ou de filtre.
- Recherches répétitives des mêmes utilisateurs, souvent le symptôme d'une base mal gouvernée.
L'erreur classique consiste à traiter le RAG comme un projet ponctuel. En production, c'est un système de connaissance vivant, avec des arbitrages permanents entre fraîcheur, qualité documentaire, performance et supervision humaine. Si vous le figez, il se dégrade. Si vous le pilotez comme une capacité d'exploitation, il reste utile et soutenable dans le temps.
AI Makers conçoit, déploie et opère des systèmes IA en production, avec une approche orientée intégration, workflows et transfert de compétences. Si vous travaillez sur une RAG entreprise et que vous voulez structurer l'architecture, la gouvernance des accès et l'exploitation dans le temps, visitez AI Makers pour explorer leurs ressources et leurs offres de transformation IA.
Google Search
Ajoutez AI Makers à vos sources préférées
Retrouvez plus facilement nos analyses dans Google lorsque le sujet est pertinent. La préférence s'applique à blogs.aimakers.fr.
Recevoir nos notes
Ce qu'on apprend en déployant l'IA dans des entreprises réelles. Une fois par mois, sans bruit.
C'est noté — vous recevrez la prochaine édition.
Cette adresse n'a pas été acceptée. Une adresse professionnelle est attendue.